대회 · 2026
2026 NYPC 회고록
로컬 승률 95%, 마지막 유저 평가 579위
로컬 rush 승률 95%, 마지막 유저 평가 579위. 숫자가 서로 반대 방향을 가리킨 이유를 돌아본다.
팀 softkleenex.로 NYPC 2026 Code Battle 예선 게임 NEXT NATION에 참가했다. 목표는 유저 상대 평가 100위권이었다. 최종 제출은 183번 봇과 data.bin이었고, 결과는 937팀 중 579위, Tier 7, rating 1710이었다. 20전 8승 2무 10패. 목표와는 거리가 멀었다.
게임과 첫 접근
NEXT NATION은 그래프 형태의 맵에서 본부와 기지를 성장시키고, 병력을 생산해 이동과 전투를 수행하는 턴제 전략 게임이다. 이동 명령은 목적지에 도착할 때까지 바꿀 수 없고, 최단경로가 여러 개면 구역 번호로 다음 칸이 결정된다. 200턴까지 양쪽 본부가 살아 있으면 본부 HP만으로 승패를 가른다. 경제, 전투, 경로 탐색과 종반 점수 관리가 한 정책 안에서 충돌한다.
처음에는 안전한 확장, 병력 생산, 가까운 적 방어 정도의 규칙으로 시작했다. 이후 본부 주변 위협과 침공 지속 시간, 전방 거점 staging, 적 본부 관문 웨이브, 종반 HQ race를 추가했다. 후보 번호를 올릴 때마다 한 가지 가설만 바꾸고, 샘플 봇과 네 종류 proxy, 이전 버전 직접 대결, 서버·유저 로그 재생으로 회귀를 찾았다.
로그가 실제 버그를 찾아준 순간들
패배 로그는 꽤 좋은 디버거였다. 기지가 모두 무너진 뒤 300골드가 있어도 유지비 여유분 때문에 재건하지 못하는 회계 문제를 찾았다. RIGHT 진영에서는 내부 구역 번호를 뒤집어 보면서 최단경로 동률 처리까지 반대로 계산하고 있었다. 이동 중인 병력이 당장 방향을 바꿀 수 있다고 가정해 카운터 레이스를 과대평가한 문제도 고쳤다.
초반 적 병력 5기 all-in, 중간 타이밍 mass rush, L3 기지와 L5 본부 수리처럼 규칙은 맞지만 정책에서 빠진 상황도 보완했다. 넓은 회군이나 성급한 공격처럼 특정 로그만 고치고 다른 대결을 망치는 후보는 버렸다. 145번 봇은 공식 8개 봇을 모두 이겼고, 과거 공식 로그 97개 재생에서도 모두 승리 분기를 만들었다. 이때까지는 검증 체계가 잘 작동한다고 생각했다.
그래프가 경고한 것
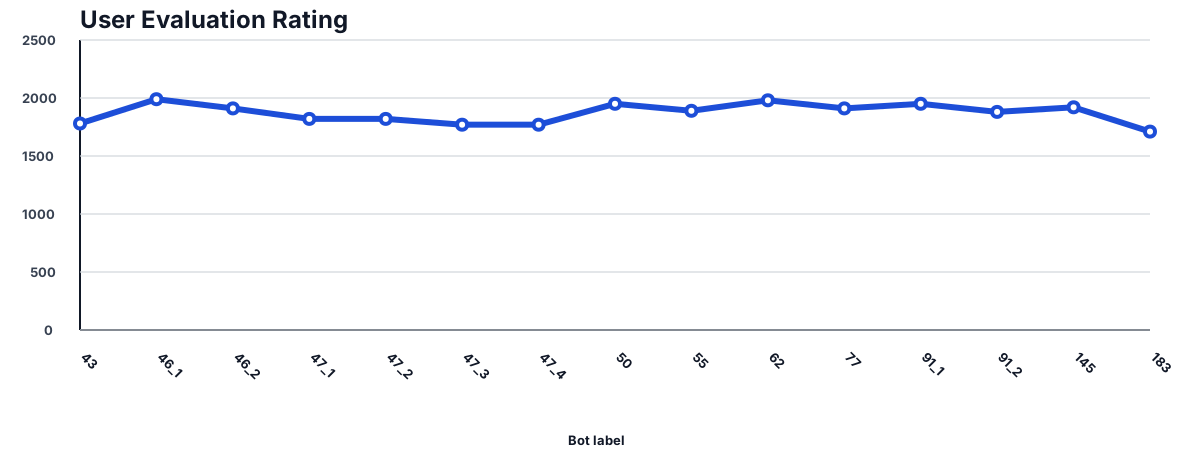
레이팅은 꾸준히 오르지 않았다. 46번에서 1990, 62번에서 1980을 기록했지만 마지막 183번은 1710이었다.
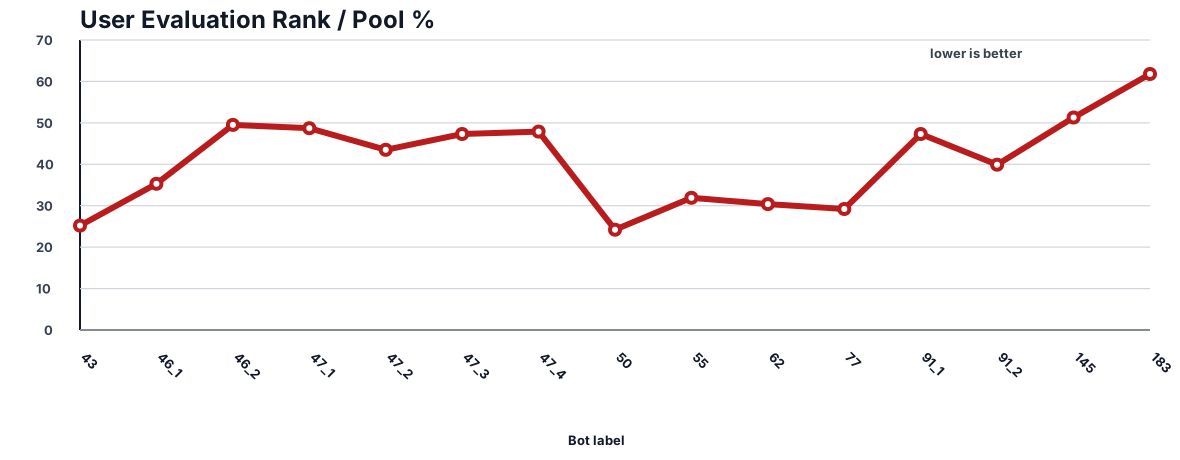
참가 팀 수를 고려한 순위 비율도 마지막에 61.8%까지 악화됐다. 반면 로컬 proxy-rush 승률은 150번의 80%에서 183번의 95%로 올랐다. 우리가 좋아진다고 믿은 지표와 실제 목표가 분리되어 있었다.
가장 큰 실수: 리플레이 WA
과거 경기 재생에서는 상대가 당시 명령을 그대로 낸다. 우리 행동을 바꿔 게임 상태가 달라지면 상대의 기록된 명령이 불가능해져 WA가 발생할 수 있다. 이때 알 수 있는 것은 오직 "원래 패배와 다른 분기가 생겼다"는 사실이다. 변화한 상황에 적응하는 상대에게 이겼다는 뜻은 아니다.
우리는 이 한계를 알고 문서에도 반복해서 적었다. 하지만 마감이 가까워질수록 "패배 세 건을 replay-WA 분기로 바꿨다"는 결과를 개선 근거로 받아들였다. 불완전한 지표라는 경고를 붙인 채, 실제 의사결정에서는 좋은 지표처럼 쓴 셈이다.
로컬 상대는 너무 익숙했다
econ, turtle, rush, punch proxy는 회귀를 찾는 데 유용했다. 그러나 모두 우리가 상상하고 구현한 전략이었다. 이전 봇과의 direct sparring도 같은 코드 계보끼리의 대결이라 새로운 플레이 스타일을 대표하지 못했다. 알려진 상대에 대한 97개 분기와 proxy-rush 95%는 정확한 수치였지만, "다양한 유저에게 강하다"는 주장에는 답하지 못했다.
좁은 예외 조건이 계속 쌓인 것도 문제였다. 각 패치는 한 로그에서 설명 가능했지만 경제, 수비, 공격 래치가 서로 영향을 주면서 전체 정책은 점점 예측하기 어려워졌다. 후반에는 새 전략을 설계하기보다 기존 조건 사이에 또 하나의 조건을 끼우는 일이 늘었다.
data.bin은 늦었고, 구조적 문제는 남았다
마지막 단계에서 맵과 상대 행동 프로필을 data.bin에 넣었다. 일부 신호는 높은 정확도를 보였지만 발생 빈도가 낮아 실제 명령을 거의 바꾸지 않았다. 데이터 파일 자체가 문제가 아니라, 무엇을 일반화할지 정한 뒤 일찍 검증했어야 할 시스템을 마감 직전에 보강책으로 붙인 순서가 문제였다.
반대로 맵의 chokepoint와 거점 가치, 다수 병력의 공동 임무 배정, 상대 이동방향 추정은 큰 변경이라는 이유로 뒤로 미뤘다. 마지막 평가에서는 기지 0개 상태의 회복, T90~160 기지 보존, 중반 HQ 직행 웨이브 방어가 여전히 약했다. RIGHT 9전에서는 1승 1무 7패였고, rating 1490과 820 상대에게도 졌다. 강한 상대를 만나서만 생긴 결과가 아니었다.
183은 정말 개선판이었나
아니다. 183은 선택한 로컬 시험에서는 145보다 좁게 나았지만, 실제 유저 분포에서 더 좋다고 확인된 봇은 아니었다. 마지막 유저 점수는 145의 9.5점에서 183의 9.0점으로 내려갔다. 두 평가는 상대가 다른 20경기라 이것만으로 183이 본질적으로 더 약하다고 단정할 수는 없다. 그러나 "로컬 무회귀"를 "실전 상위호환"으로 번역할 근거도 없었다.
다시 참가한다면
- 전략 계열이 다른 상대 풀을 만들고 일부 seed와 상대는 끝까지 보지 않는 holdout으로 고정한다.
- 리플레이 WA는 승리가 아니라
diverged로만 기록한다. - 승률을 진영, 맵 구조, 상대 확장 속도와 첫 공격 시점별로 분해한다.
- 경제·방어·공격을 명시적 모드로 나누고, 병력을 개체가 아닌 임무 단위로 배정한다.
data.bin은 초기부터 재현 가능한 맵 프로필 산출물로 관리한다.- 마지막 날의 새 기능보다 두 번 이상 유저 평가에서 반복된 개선을 신뢰한다.
끝나고 남은 것
100위권 목표는 실패했다. 그래도 300개의 유저 match log와 공식 로그를 정형화했고, 183번까지 이어진 가설과 기각 사유를 남겼다. 무엇보다 로컬 성능과 평가 성능은 같은 말이 아니라는 사실을 숫자로 배웠다.
다음 전략 게임에서 가장 먼저 만들 것은 더 복잡한 공격 알고리즘이 아니다. 내가 만든 봇이 무엇에 강하고 무엇에 약한지 정직하게 말해 주는 평가 환경이다.